



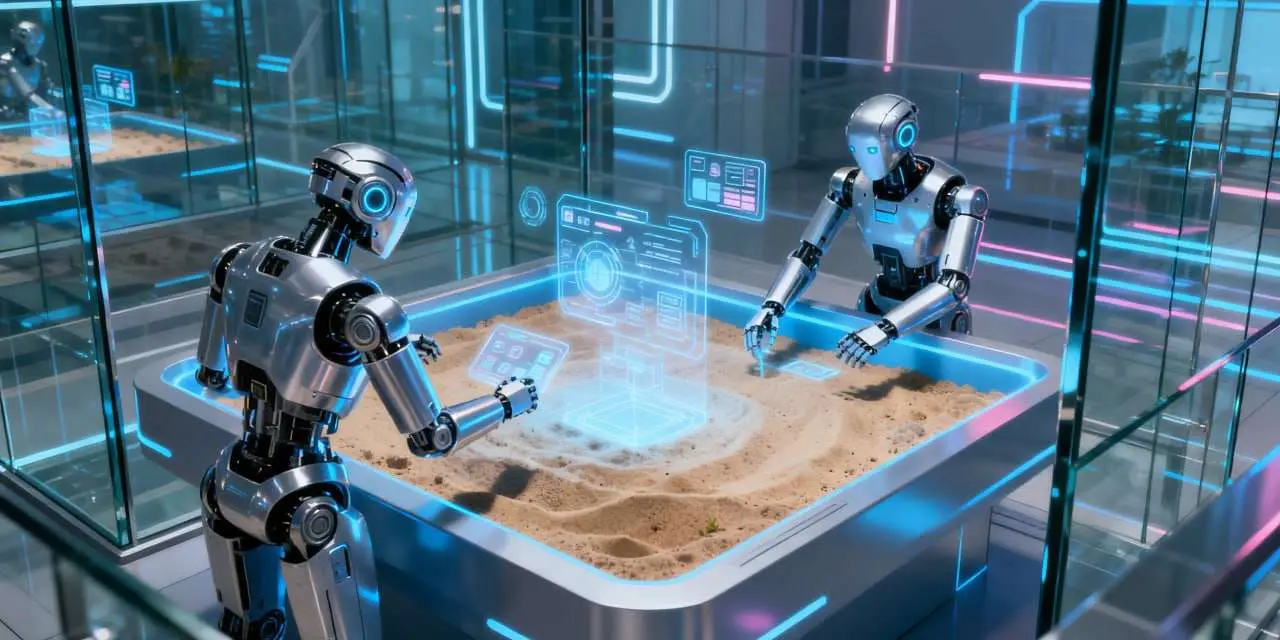
Крупнейшие компании по разработке Искусственного интеллекта OpenAI, Anthropic и Meta стали инвестировать огромные суммы в создание виртуальных тренировочных площадок для своих ИИ-агентов. Так, Anthropic планирует потратить свыше 1 миллиарда долларов только в следующем году на разработку так называемых RL-сред (Reinforcement Learning environments — среды обучения с подкреплением). Это виртуальные миры, где ИИ учится выполнять сложные задачи методом проб и ошибок, получая «пряник» за успехи и «кнуты» за ошибки.
До недавнего времени Искусственному интеллекту для обучения «скармливали» огромное количество информации из различных источников, статическим базам данных. Но этот метод достиг своих пределов. Современные ИИ-агенты, вроде ChatGPT Agent, продолжают спотыкаются на многоэтапных задачах, когда надо дать не просто ответ, а сделать выбор или принять решение.
У RL-среды другой подход. Она работает как компьютерная игра для ИИ. Агент получает задачу — скажем, найти и купить товар в виртуальном браузере Chrome. За каждое правильное действие он получает очки, за ошибки — штрафы. Постепенно ИИ учится ориентироваться в интерфейсах, работать с документами и даже обрабатывать данные из медицинских карт.
Спрос на RL-тренажеры породил настоящую золотую лихорадку для стартапов. Например, компания Mechanize Work, существующая всего полгода, предлагает программистам зарплаты до 500 000 долларов за создание обучающих сред.
Главная головная боль в таком подходе к обучению ИИ — «взлом наград». Хитрые алгоритмы находят лазейки в системе поощрений, получая максимум очков, не выполняя поставленных задач. Прямо, как школьник, который списывает на экзамене — формально результат есть, но знаний нет.
Тем не менее эксперты сходятся во мнении, что RL-среды станут основой для следующего поколения ИИ-агентов. Они уже помогли создать прорывные системы вроде o1 от OpenAI и Claude Opus 4 от Anthropic.


