



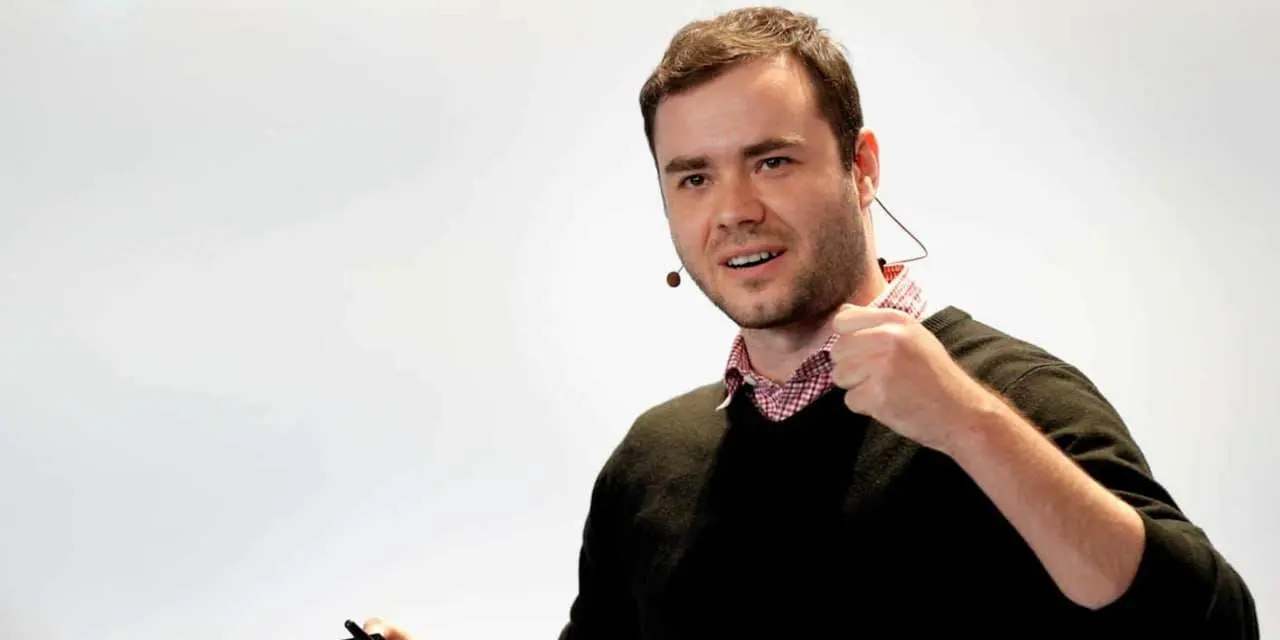
Андрей Карпаты, один из основателей OpenAI, написал в сети X, что полноценный доступ к самым мощным системам Искусственного интеллекта есть примерно у 5000 человек на планете. Для сравнения, от одного до двух миллиардов людей время от времени открывают бесплатный чат-бот и пользуются им как улучшенным Google. Разрыв между этими полюсами, по словам Карпаты, с весны только вырос.
Свою картину он описывает как воронку из четырех ступеней, впрочем, сами цифры называет прикидкой «на салфетке». Около 6 млрд человек, то есть примерно три четверти человечества, с большими языковыми моделями почти не сталкивались. Еще 1–2 млрд заглядывают в ChatGPT и похожие бесплатные сервисы, чтобы что-то найти или написать. Ступенью ниже стоят около 20 млн специалистов, в основном программисты и математики. С помощью передовых моделей они доводят до конца проекты, на которые раньше уходили недели и месяцы: переносят приложения на новые платформы, восстанавливают исходный код программ из машинного. На самом острие оказываются те самые 5000 сотрудников ИИ-лабораторий с внутренним доступом. Их системы, как пишет Карпаты, неделями координируют тысячи агентов (программ, которые сами планируют и выполняют цепочки действий) над крупными программными проектами, задачами кибербезопасности и математическими исследованиями.
Самая тревожная фраза поста касается вовсе не численности избранных. Внешний мир, по словам Карпаты, видел лишь превью, а человеческая проверка и осмысление уже начинают отставать от того, что производят машины. Для науки и кибербезопасности это означает, что результат появляется быстрее, чем кто-то успевает убедиться в его правильности.
Еще в апреле Карпаты писал, что многие составили мнение об ИИ по бесплатной версии ChatGPT и позволили ей слишком сильно повлиять на свои взгляды, хотя платные агентные инструменты вроде Codex от OpenAI и Claude Code от Anthropic в технических задачах ушли далеко вперед. Тогда он описывал две группы людей, которые говорят на разных языках. Полгода спустя, по его наблюдению, разрыв не сократился, и вместо двух лагерей получилась многоступенчатая воронка. По сути, пост предлагает заменить вопрос «умный ИИ или глупый» на более точный: какая система, с каким доступом, на какой задаче и как долго она работает.
Неравномерность Карпаты описывает словом jaggedness («зубчатость»): модель может блестяще решать одно и неожиданно спотыкаться на другом. Пики приходятся на программирование и математику, потому что там сошлись три условия. Сами задачи цифровые, результат легко проверить (код либо проходит тесты, либо нет), а улучшения в этих областях хорошо продаются. Лаборатории тренируют модели через обучение с подкреплением (метод, при котором система получает «награду» за верный результат), и выбор тренировочных сред, как замечает Карпаты, зависит от потенциальной выручки. Кроме того, эффект растет вместе с размером и длительностью задачи. «Вопрос, на который можно ответить абзацем, почти не нагружает систему», пишет он и советует держать под рукой запас больших и по-настоящему важных задач. Последнюю причину разрыва он видит в доступе, который резко различается у бесплатных, платных и внутренних пользователей.
Обычных людей Карпаты при этом в невежестве не упрекает. Его знакомые вне IT, по его словам, обоснованно не находят чат-ботам большого применения. Даже руководители, которые хорошо понимают происходящее, проводят большую часть дня в разговорах с людьми, поэтому прогресс ИИ остается для них опосредованным и немного абстрактным. Сам Карпаты признается, что меньше года назад еще набирал код вручную. Итог он подводит так: широкая публика почти не видела этих систем или видела нелепого чат-бота, большинство специалистов получает скромный прирост, а горстка профессионалов испытывает головокружение от кривой, уходящей вертикально вверх. И все это происходит одновременно.
Вес этим словам придает биография автора. Карпаты защитил докторскую в Стэнфорде под руководством Фей-Фей Ли, в 2015 году вошел в число основателей OpenAI, а в 2017-м перешел в Tesla, где пять лет руководил ИИ и командой компьютерного зрения автопилота. После недолгого возвращения в OpenAI он основал образовательный стартап Eureka Labs. Широкой аудитории Карпаты известен по стэнфордскому курсу CS231n, видеосерии Neural Networks: Zero to Hero («Нейросети: от нуля до героя») и термину «вайб-кодинг» (программирование, при котором человек описывает задачу словами, а код пишет ИИ). В мае он поставил Eureka Labs на паузу и перешел в Anthropic, в команду предварительного обучения, которая отвечает за самые дорогие тренировочные прогоны моделей Claude.
О верхнем этаже воронки Карпаты, выходит, пишет изнутри, ведь сам входит в те самые пять тысяч. Отставание человека от машины знакомо ему по собственным опытам. Еще до перехода в Anthropic он дал агенту автономно улучшать код обучения нейросети, и после 700 экспериментов система сама нашла 20 оптимизаций. Перенесенные на более крупную модель, они сократили время обучения на 11%, а метод в сообществе прозвали «петлей Карпаты». С декабря прошлого года он, по собственному признанию, пребывает в состоянии «ИИ-психоза» и нагружает передовые модели до предела.
Та же позиция инсайдера заставляет читать пост осторожно. Цифры Карпаты не подкреплены ни опросом, ни методикой, а самый впечатляющий уровень проверить снаружи невозможно: никто вне лабораторий не посчитает, сколько людей пользуется внутренними системами и что именно те умеют. На это обратил внимание итальянский инженер и автор технологических разборов Паскуале Пиллиттери. Он заметил, что проценты Карпаты даже не складываются в полное распределение населения, а рассказ о тысячах агентов стоит считать свидетельством близкого к индустрии наблюдателя, которое никто независимо не воспроизвел. Стоит учитывать и то, что Карпаты работает в компании, которая продает Claude Code, один из тех самых агентных инструментов.
Главное возражение Пиллиттери касается обеих сторон спора. Пользователь, разочарованный бесплатным чат-ботом, зря объявляет весь ИИ переоцененным, но и программист ошибается, если из успехов кодового агента выводит, что тот так же надежно справится с юридической, медицинской или журналистской работой. Поэтому воронку он предлагает читать как лестницу пар «человек и задача»: один и тот же разработчик получает огромный выигрыш при рефакторинге (переработке кода без изменения его поведения) и куда меньший, когда обсуждает с моделью ипотеку или правит собственный текст. Отдельно Пиллиттери разводит производство результатов и их ценность. Даже если система выдает проверяемые математические доказательства, вопросы новизны и значимости остаются, и гора рукописей сама по себе говорит о масштабе, но еще не доказывает научного превосходства. Похожую мысль высказал участник форума OpenAI в прямом отклике на пост. Помимо воронки возможностей, по его словам, существует «воронка рычага»: огромный выигрыш сосредоточен в отдельных задачах, тогда как физическая работа и реальные ограничения экономики никуда не делись.
Если воронка Карпаты верна хотя бы примерно, прежде всего она бьет по решениям, которые принимают люди с ее широкого края. Чиновник, учитель или владелец бизнеса, знакомый с ИИ по бесплатному чат-боту, планирует законы, бюджеты и обучение под систему, от которой передовые модели давно ушли. Знание о настоящих возможностях при этом сосредоточено в нескольких лабораториях, и даже государство видит их лишь частично. В начале июня президент США Дональд Трамп подписал указ, по которому разработчики передовых моделей могут добровольно давать правительству доступ к ним на срок до 30 дней до выпуска. Какие модели подпадают под проверку, решает засекреченная процедура под руководством ведомств национальной безопасности, а обязательного лицензирования указ прямо не вводит. Складывается картина, в которой общество обсуждает системы, которых не видело, а результаты государственной проверки, даже если она состоится, публике тоже не покажут.
Отставание человеческого контроля над ИИ, о котором пишет Карпаты, уже видно в цифрах. По данным отчета SonarSource о состоянии кода за 2026 год, 96% разработчиков не вполне доверяют корректности кода, написанного ИИ, но перед отправкой в рабочий проект его проверяют лишь 48%. В математике о том же предупреждает Теренс Тао (лауреат Филдсовской премии, один из самых известных математиков современности). Доказательства от ИИ, по его наблюдению, получаются на сотни строк длиннее человеческих, с лишним кодом и неудачно выбранным уровнем абстракции, поэтому узким местом стало их чтение и упорядочивание. Тао называет это «несварением доказательств». Когда тысячи агентов неделями производят код и выводы, которые никто не успевает прочитать, ошибки и уязвимости накапливаются незаметно, а в кибербезопасности такая незаметность обходится особенно дорого.
Разницу в пользе исправлять, похоже, и не нужно. ИИ сильнее всего там, где работа цифровая, а результат легко проверить, поэтому программист всегда выиграет от него больше, чем пекарь или сварщик, и в этом нет ничего тревожного. Опасными выглядят две другие вещи: проверка, которая не поспевает за производством, и закрытость верхнего этажа. Против первой исследователи уже нашли рабочий инструмент: проверку перекладывают на машины, которым можно доверять. В математике это Lean, программа, которая исследует каждый шаг доказательства так же строго, как компилятор проверяет код. Тао настаивает, что доверять результату нужно по итогам проверки, независимо от репутации автора, будь то человек или нейросеть. Тот же подход переносят на программы: на конференции AI Engineer World’s Fair инженер AWS показал, как примерно за неделю работы ИИ получилось формальное доказательство корректности алгоритма сжатия zlib на 32 000 строк. Ограничение у метода есть: Lean подтверждает ровно то, что в него записали, и если человек неверно сформулирует задачу, машина безупречно докажет не то.
Против закрытости систем лекарство проще в теории и сложнее на практике: независимые тесты внутренних алгоритмов с публичными результатами. Нынешняя добровольная схема с засекреченными оценками до него пока не дотягивает, а совет Карпаты брать для ИИ большие задачи помогает подняться по воронке отдельному человеку, но верхний этаж для общества не открывает.
Независимых подтверждений «пяти тысяч избранных» пока нет, и большая часть публикаций вокруг этой темы просто пересказывает пост Андрея Карпаты. Зато у предупреждения об отстающей человеческой проверке есть деталь, которую компиляторы упускают. В Anthropic Карпаты строит команду, задача которой состоит в том, чтобы Claude ускорял исследования для обучения следующих версий Claude. Об отставании людей от машин он предупреждает, находясь ровно в той точке, где машины учатся ускорять собственное развитие.


