



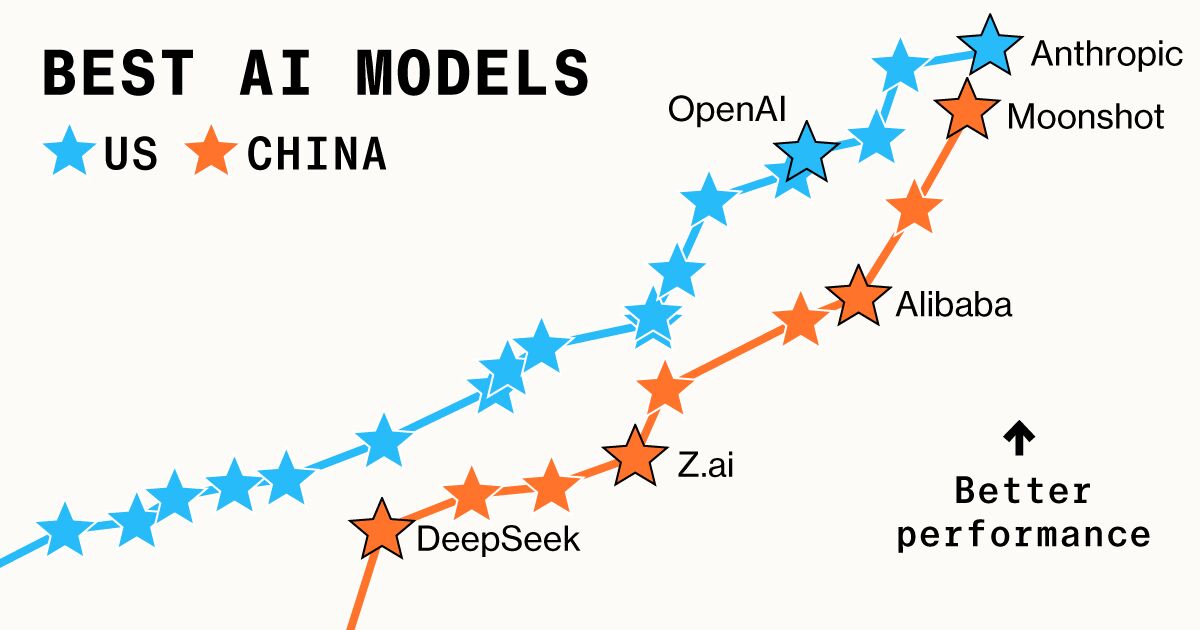
Лучшие китайские модели Искусственного интеллекта отстают от американских всего на 3%, подсчитал старший аналитик Bloomberg Intelligence Роберт Ли. В мае разрыв составлял около 9%, а в начале года доходил до 15%. Последний рывок обеспечила DeepSeek, выпустившая в сентябре модель V4.1 Flash.
Цифра опирается на рейтинг LiveBench, который сравнивает модели на задачах по рассуждению, математике и программированию. Сейчас DeepSeek V4.1 Flash в режиме максимальных усилий набирает 81,1 балла, а лидер, Claude Fable 5.1 от Anthropic, — 83,4. Разница в 2,3 балла и дает те самые 3%. В отдельных дисциплинах китайская модель уже впереди: в агентном программировании (когда модель сама пишет, запускает и правит код) у нее 77,3 балла против 66,1 у Fable.
Секрет DeepSeek в экономии. По описанию самой компании, при обработке запроса работает лишь небольшая часть параметров модели, а кэш, в котором хранится контекст разговора, удалось заметно ужать. Отсюда и цены: доступ через API (интерфейс, через который программы обращаются к модели) в непиковые часы стоит вдвое дешевле пикового тарифа. Параллельно DeepSeek идет к независимости от американского «железа». В конце сентября она открыла набор инструментов для ускорителей Huawei Ascend, включая язык TileLang, который предлагает как более простую альтернативу CUDA, фирменной платформе Nvidia. По данным Bloomberg, компания собирается развернуть не меньше 160 тысяч ускорителей Huawei в дата-центре во Внутренней Монголии.
На рынке всё сложнее, чем показывают рейтинги. По данным JPMorgan Asset Management, китайские модели на платформе OpenRouter обработали больше токенов — фрагментов текста, по которым измеряют объём работы модели. Однако американские модели получили немного больше запросов. Во многом это связано с ИИ-агентами: они могут тратить очень много токенов на одну задачу и заметно влиять на статистику. Кроме того, OpenRouter не отражает весь корпоративный рынок: крупные американские компании в основном используют американские модели, а китайские — местные.
Методика подсчёта тоже может заметно менять картину. В Стэнфордском индексе ИИ сравнивают результаты моделей в наборе стандартных тестов: они решают задачи на знания, логику, программирование, математику и другие навыки. Затем эти результаты сводят в общий показатель и по нему оценивают разрыв между моделями. По такой методике преимущество лидеров оказалось еще меньше — 2,7%.
Но рейтинги показывают прежде всего, насколько хорошо модель справляется с тестовыми заданиями. Для компаний важнее другое: стабильно ли она работает в реальных задачах, безопасно ли её внедрять и законно ли были получены данные для обучения. Открытые веса позволяют скачать модель и запускать её на собственных серверах, но сами по себе не объясняют, какие данные использовали при её обучении и можно ли применять такую модель без юридических рисков.
Для Вашингтона новость неприятна в первую очередь политически. Вся стратегия США держится на экспортном контроле: не дать Китаю передовые чипы, и разрыв сохранится сам собой. Сжатие отставания с 15% до 3% за год показывает, что лаборатории из КНР выигрывают изобретательностью там, где им не хватает вычислительной мощности. Ли прямо ожидает, что улучшение качества принесет китайским разработчикам новую долю рынка.
Но у этой гонки есть и обратная сторона, о которой аналитик говорит не менее прямо. В Китае работает больше 1100 больших языковых моделей, большинство разработчиков продают токены почти по себестоимости, а чат-боты DeepSeek и Tencent остаются бесплатными. Единственным заметным примером монетизации Ли называет Doubao от ByteDance. «Чтобы вывести китайский сектор ИИ на устойчивую прибыль, понадобится охлаждение конкуренции, встряска отрасли и более разумный подход к ценам», — считает он. До тех пор, по его прогнозу, индустрия может оставаться убыточной вплоть до 2030 года.


