





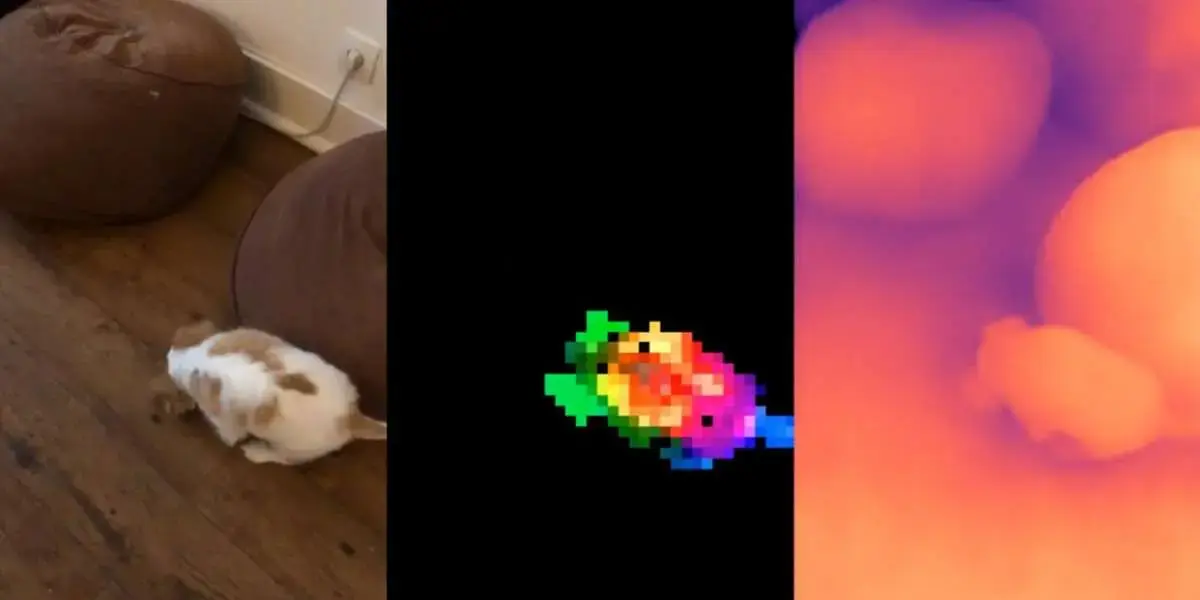
Компания Meta выпускает модель компьютерного зрения DINOv2 с открытым исходным кодом под лицензией Apache 2.0. DINOv2 способна выполнять различные задачи, включая семантическую сегментацию изображений и монокулярную оценку глубины.
Кроме того, Meta также представила FACET — эталон для оценки справедливости моделей компьютерного зрения в таких задачах, как классификация и сегментация. Набор данных включает 32 000 изображений 50 000 человек с демографическими атрибутами, такими как предполагаемый пол и возрастная группа, в дополнение к физическим характеристикам.
FACET призван стать стандартным эталоном для оценки справедливости моделей компьютерного зрения и стимулировать проектирование и разработку моделей, учитывающих большее количество людей.
DINOv2, как и его предшественник DINO, представляет собой модель компьютерного зрения, обученную методом самоконтроля, и, по данным Meta, она работает не хуже большинства современных специализированных систем во всех задачах, рассматриваемых в бенчмарках. Благодаря самоподдерживающемуся обучению не требуются помеченные данные, и модели DINO могут быть обучены на больших массивах немаркированных изображений.

"DINOv2 предоставляет высокопроизводительные функции, которые могут быть непосредственно использованы в качестве входных данных для простых линейных классификаторов", — сообщает Мета. Это делает DINOv2 гибким и универсальным инструментом для решения широкого спектра задач компьютерного зрения, от задач на уровне изображений (классификация изображений, поиск экземпляров, понимание видео) до задач на уровне пикселей (оценка глубины, семантическая сегментация).
По мнению Meta, модели DINOv2 могут быть полезны для различных приложений, включая картирование лесов в Институте мировых ресурсов, оценку плотности и численности животных, а также биологические исследования, такие как микроскопия клеток.
Для обучения модели компания собрала 1,2 млрд. изображений, отфильтровала и сбалансировала набор данных. В итоге DINOv2 был обучен на 142 млн. изображений. Как и предшественник, DINOv2 опирается на систему Vision Transformers.
Meta планирует объединить DINOv2 с большими языковыми моделями для создания более мощных моделей для анализа и обработки изображений. "Визуальная основа, предоставляющая богатую информацию об изображениях, позволит сложным системам ИИ рассуждать об изображениях более глубоко, чем при описании их одним текстовым предложением".
Более подробную информацию можно найти на странице проекта. Там же размещены демонстрационные версии DINOv2. Код и контрольные точки доступны на Github.


