





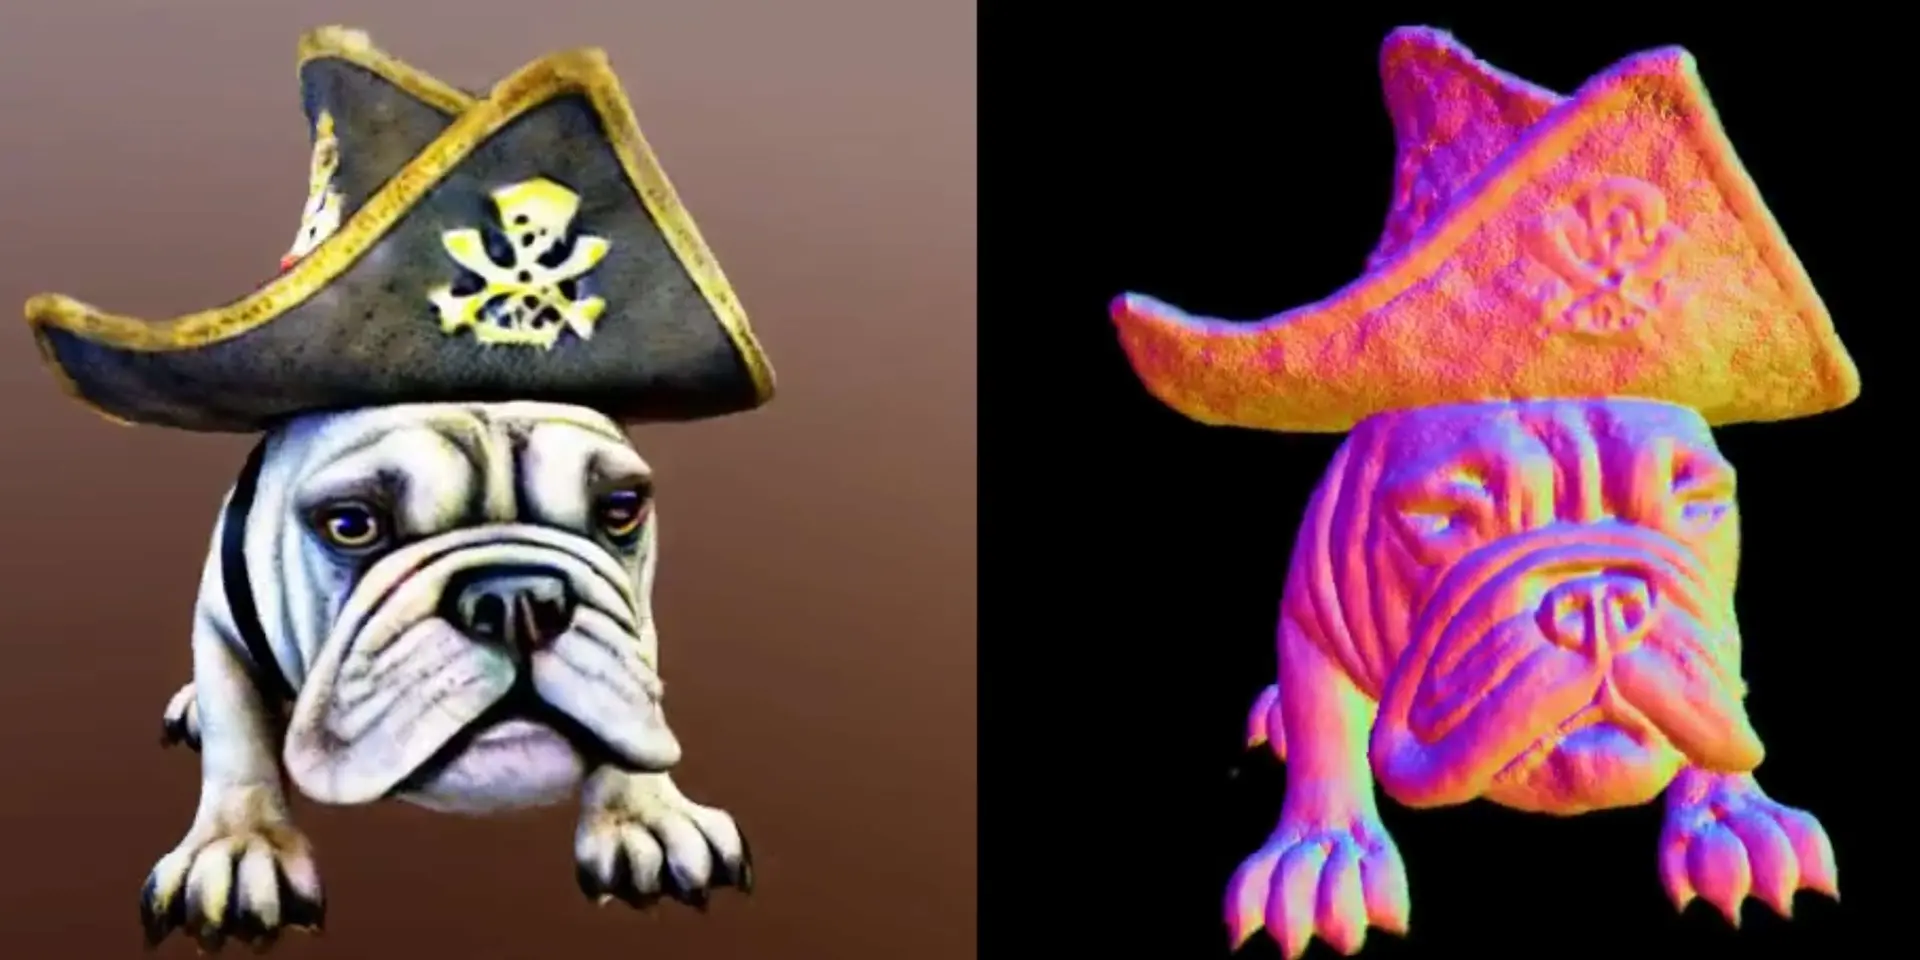
Исследователи из ByteDance представили MVDream (Multi-view Diffusion for 3D Generation) — диффузионную модель, способную генерировать высококачественные 3D-изображения из текстовых подсказок. Подобные модели уже существуют, но MVDream позволяет достичь сравнительно высокого качества и избежать таких распространенных артефактов, как проблема Януса или дрейф контента (например, когда сгенерированный объект может иметь несколько лиц / тарелка с вафлями меняет количество и расположение вафель в зависимости от угла обзора).
Для решения проблемы артефактов ByteDance обучал диффузионную модель типа Stable Diffusion не только на обычных парах "подсказка-изображение", но и на нескольких видах 3D-объектов. Для этого исследователи визуализировали большой набор 3D-моделей с различных ракурсов и углов обзора.
По словам специалистов, видя целостные изображения с разных углов, модель, используя технологии Stable Diffusion и NeRF, научилась создавать целостные 3D-фигуры вместо несвязанных 2D-изображений.
К недостаткам модели можно отнести низкое разрешение 256х256 пикселей и ограниченную обобщающую способность. Однако ByteDance планирует, что в будущем обе эти проблемы могут быть разрешены за счет использования более крупных моделей диффузии, таких как SDXL. Для существенного улучшения качества и стиля 3D-рендеринга, по мнению команды, скорее всего, потребуется длительное обучение с использованием нового набора данных.
Более подробная информация и примеры доступны на GitHub MVDreams.


