





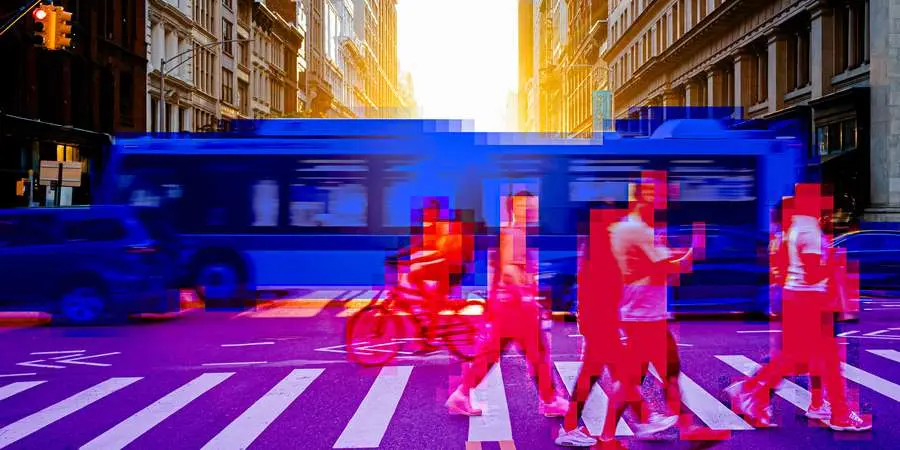
Исследователи Массачусетского технологического института представили новую модель компьютерного зрения, которая может выполнять семантическую сегментацию изображений высокого разрешения гораздо эффективнее, чем предыдущие модели. Семантическая сегментация предполагает маркировку и категоризацию всех пикселей изображения. Благодаря этому автономные транспортные средства смогут точно распознавать такие объекты, как другие автомобили, пешеходы и окружающие их предметы, а медицинские системы ИИ — распознавать опухолевые ткани.
Новая модель EfficientViT, основанная на Vision Transformer, позволяет точно выполнять семантическую сегментацию в режиме реального времени на устройствах с ограниченными аппаратными ресурсами, например, на бортовых компьютерах, позволяющих автономным автомобилям принимать решения в доли секунды.

Современные модели семантической сегментации напрямую изучают взаимодействие между каждой парой пикселей на изображении, поэтому их вычисления растут квадратично при увеличении разрешения изображения. В связи с этим, несмотря на точность таких моделей, они слишком медленны для обработки изображений высокого разрешения в реальном времени на периферийных устройствах, таких как сенсор или мобильный телефон.
Исследователи Массачусетского технологического института разработали EfficientViT для моделей семантической сегментации, которая позволяет достичь тех же возможностей, что и эти современные модели, но при этом обладает линейной вычислительной сложностью и эффективными аппаратными операциями.
При использовании линейной функции теряется точность, поскольку она учитывает только глобальный контекст изображения, а не локальную информацию. Чтобы компенсировать потерю точности, исследователи включили в свою модель два дополнительных компонента.
Один из этих компонентов помогает модели улавливать взаимодействие локальных признаков, смягчая недостаток линейной функции при извлечении локальной информации. Второй — модуль, обеспечивающий мультимасштабное обучение, — помогает модели распознавать как крупные, так и мелкие объекты.
EfficientViT при развертывании на мобильном устройстве работает в девять раз быстрее, чем предыдущие модели, а также демонстрирует такую же или более высокую точность, чем альтернативные варианты.
Такая более эффективная обработка может обеспечить сегментацию в реальном времени в таких приложениях, как автономные транспортные средства, медицинская визуализация и VR-гарнитуры. Разработанная модель может быть применена и для решения других задач компьютерного зрения, например, для классификации изображений.
Код и модель доступны на GitHub.


