





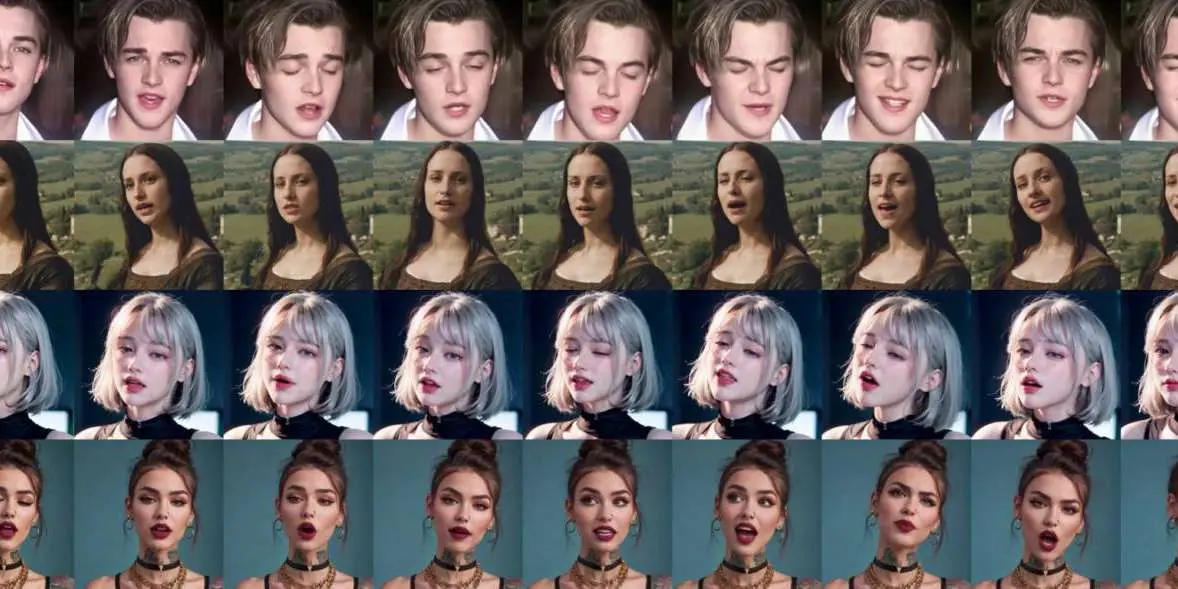
Исследователи из Alibaba представили EMO, новую систему искусственного интеллекта (ИИ), которая использует комбинацию техник обработки изображений и звука, чтобы анимировать персонажа на статичном изображении и создать впечатление, что он говорит или поет. В качестве входных данных модель принимает изображение (фото, портрет, анимация) и аудиофайл.
Традиционные методы создания видео с "говорящими головами" часто не могут передать весь спектр эмоций и выражений лица. Методы, основанные на 3D-моделировании, часто не могут передать сложную мимику. Методы прямого генерирования испытывают трудности с согласованностью во времени. Однако EMO показывает, что при наличии достаточного количества данных и соответствующей структуры ИИ может создавать удивительно яркие видеоролики "говорящей головы", передающие все нюансы речи.
В основе EMO лежит глубокая нейронная сеть, использующая диффузионные модели, такие же, как в DALLE или Midjourney. Обучая эти модели на аудио, а не на тексте или изображениях, EMO учится перестраивать мимику в точном соответствии со звуком.
Система способна улавливать тонкости человеческой речи и пения, создавая анимацию, очень похожую на естественные движения речевых мышц человека.
При этом выходные данные могут быть любой длины — все зависит от входного аудио. Это означает, что можно создавать длинный контент с неизменным качеством.
EMO уже демонстрировалась на нескольких мероприятиях и конференциях и получила широкое признание за свои инновационные и впечатляющие возможности. Это все еще относительно новая технология, но она имеет потенциал для революции в нашем взаимодействии с цифровыми медиа и создания новых возможностей для развлечений, образования и коммуникации. Технология может использоваться для создания персонализированных аватаров для виртуальных помощников, персонажей игр и других приложений.


