





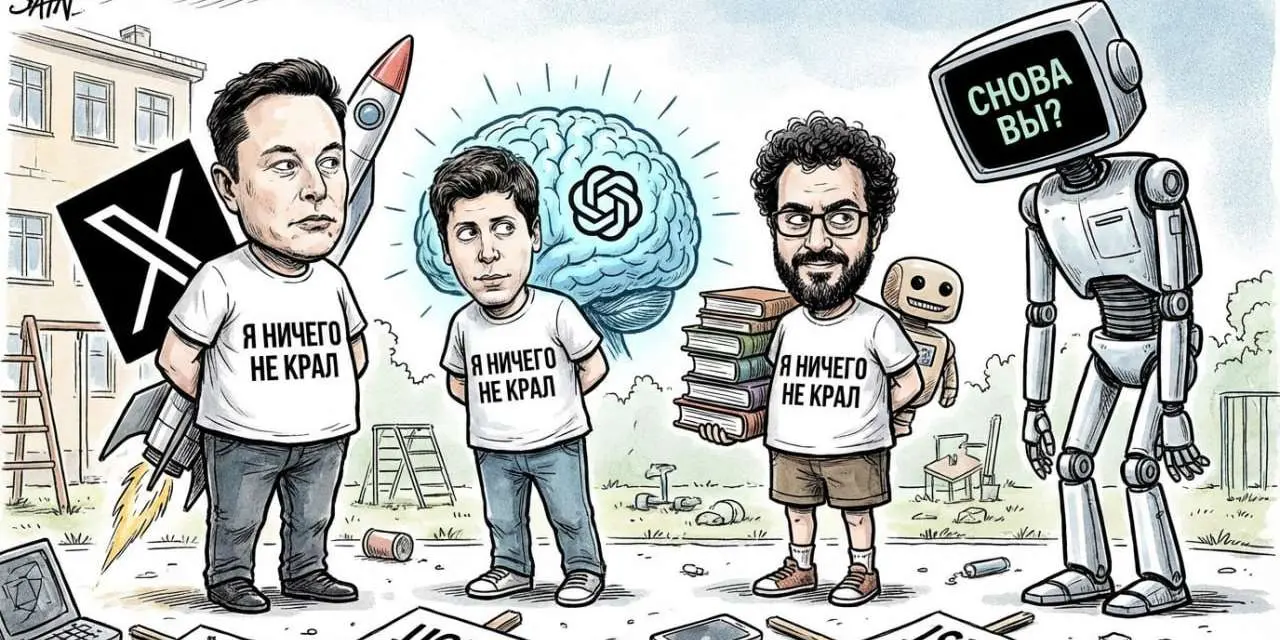
Компания Anthropic обвинила китайских конкурентов в краже данных. Илон Маск немедленно обвинил саму Anthropic. OpenAI обвиняет DeepSeek. DeepSeek молчит и выпускает новые модели. Добро пожаловать в эпоху, когда воры судятся с ворами за то, что те воруют у воров.
Anthropic опубликовала собственное расследование: три китайские компании (DeepSeek, Moonshot AI и MiniMax) создали около 24 000 фиктивных аккаунтов, которые обращались к нейросетям Claude более 16 миллионов раз. Цель — дистилляция (model distillation): это когда мощная модель-«учитель» отвечает на огромное количество запросов, а её ответы используют для обучения более дешёвой модели-«ученика».
Лидером по запросам оказалась MiniMax — 13 миллионов обращений. Moonshot AI — 3,4 миллиона. DeepSeek — скромные 150 000. Для сравнения: обыкновенный пользователь делает сотни запросов в месяц. 16 миллионов — это промышленная добыча данных.
Anthropic заявила, что такие дистиллированные модели лишены встроенных ограничений безопасности (safeguards) и могут использоваться для кибератак, дезинформации и слежки.
Выявить дистилляцию сложно, но можно. Системы мониторинга фиксируют аномальный трафик: тысячи аккаунтов с похожими паттернами запросов, использование коммерческих прокси-сервисов (посредников, скрывающих источник трафика), нехарактерные объёмы и темп обращений.
Дистилляция — легитимный метод внутри одной компании, когда одна модель учится у другой. Проблема начинается, когда данные начинают запрашивать у конкурентов. При этом информацию можно «адаптировать»: запросы формулируются так, чтобы ответы модели содержали нужный культурный контекст, обходили нежелательные темы или усиливали определённые нарративы.
И тут появился Илон Маск. Он указал, что в сентябре 2025 года Anthropic сама выплатила $1,5 млрд (крупнейшее в истории США возмещение по делу об авторских правах) после того как суд установил: компания скачала более 7 миллионов пиратских книг из теневых библиотек Library Genesis и Pirate Library Mirror. Параллельно музыкальные лейблы во главе с Universal Music Group требуют ещё $3 млрд за незаконную загрузку 20 000 треков через BitTorrent.
OpenAI тоже «в деле»: компания обвиняет DeepSeek в дистилляции своих моделей, однако сама стоит под прицелом десятков исков от авторов, газет и медиакомпаний за использование их материалов без разрешения. Google судится с несколькими сервисами для автоматизированного сбора и структурирования данных из поисковых систем (парсерами), xAI обвиняют в пиратстве данных из Twitter. Список можно продолжать.
Картина складывается занятная: каждый крупный игрок в той или иной мере строил свои модели на чужом контенте — текстах, книгах, коде, музыке. Данные брались согласия и компенсации авторам. Теперь те же компании возмущаются, когда конкуренты применяют аналогичную логику уже к их продуктам.
И здесь есть интересная юридическая коллизия. Авторское право распространяется на конкретные тексты и произведения. Если вы автор и ваши наработки «позаимствовали» для обучения нейросетей, то вы смело можете подавать в суд. Фемида будет на вашей стороне. А вот API-ответы модели формально могут не являться охраняемым объектом — суды ещё не выработали единой позиции. Именно поэтому Anthropic делает упор не на интеллектуальную собственность, а на нарушение условий использования сервиса и угрозу национальной безопасности.
Ответственность пока размытая. Штрафов за дистилляцию чужих моделей как таковых не существует. Китайские компании формально находятся вне юрисдикции американских судов. Реальные последствия — блокировка аккаунтов, внесение в реестры рисков для цепочки поставок Пентагона, дипломатическое давление.
Вся эта история «кто у кого что украл» разворачивается в правовом вакууме. Мировая законодательная база явно отстает от технологического прогресса и «лайфхаков», которые придумывают компании для удешевления стоимости обучения своих нейросетей. Когда Anthropic называет дистилляцию «промышленной кражей», она права технически. Но она же построила бизнес стоимостью в десятки миллиардов долларов на том, что сама взяла без спроса у всего человечества.


