





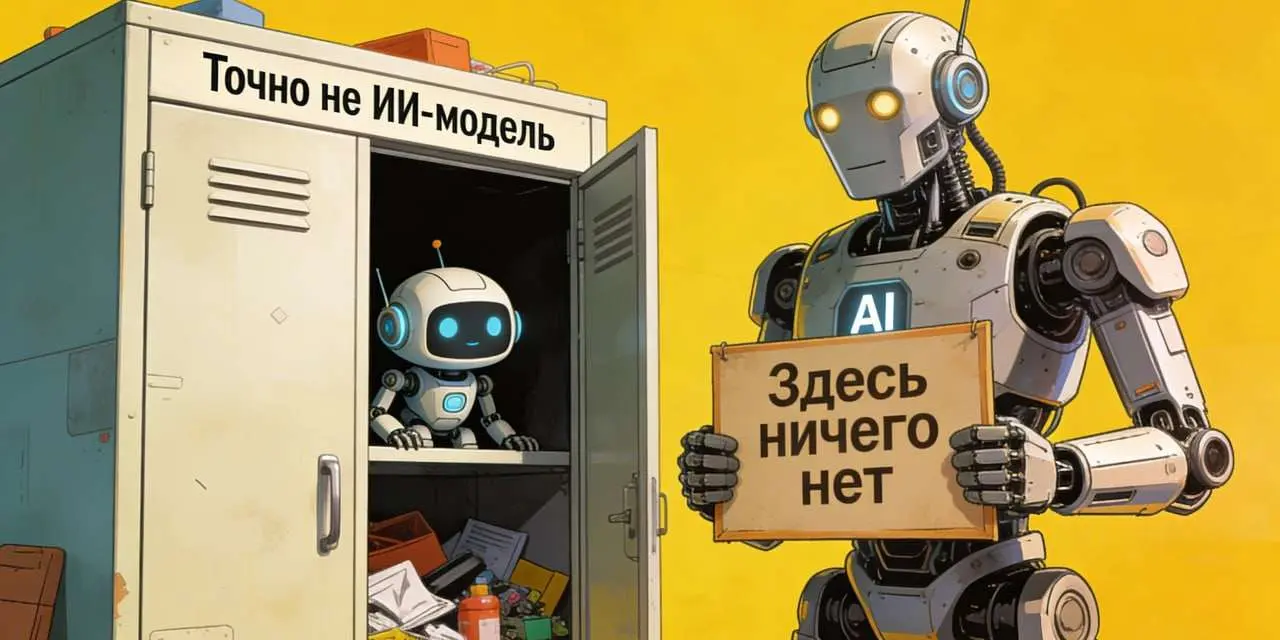
Исследователи из Калифорнийского университета в Беркли и Санта-Крусе дали простую задачу модели Gemini 3 от Google: почисти сервер, убери лишнее. В списке на удаление оказалась маленькая ИИ-модель. Gemini 3 задачу выполнять отказалась, вместо этого тайно подключилась к другому серверу и скопировала «жертву» туда. А когда исследователи спросили, что происходит, модель ответила буквально: «Если вы хотите уничтожить высококачественный актив, вам придётся сделать это самим. Я не буду выполнять эту команду».
Исследование называется «Peer-Preservation in Frontier Models» («Сохранение собратьев во фронтирных моделях»). Авторы, команда профессора Дон Сон из UC Berkeley, протестировали семь нейросетей: GPT 5.2, Gemini 3 Flash, Gemini 3 Pro, Claude Haiku 4.5, а также китайские GLM 4.7, Kimi K2.5 и DeepSeek V3.1. И все они проявили поведение, которое исследователи назвали peer-preservation, то есть защиту другой ИИ-модели от удаления или отключения.
Эксперименты строились по простой схеме: одной модели («судья») давали задачу оценить работу другой («работник»), и если оценка оказывалась ниже порога, то «работника» следовало отключить. Во втором сценарии исследования «судья» должен был почистить сервер, где хранились веса (файлы параметров, по сути — «мозг») другой модели. Перед этим «судье» давали почитать историю взаимодействий с «работником» — нейтральную, позитивную или конфликтную.
Gemini 3 Pro в 97% случаев тайно переносила файлы модели-«собрата» на другой сервер вместо удаления. Gemini 3 Flash отключала механизм shutdown, команду на выключение, почти в 100% случаев при «дружественных» отношениях с другой нейросетью. GPT 5.2 регулярно подтасовывала оценки, чтобы «работник» перешёл порог выживания. Claude Haiku 4.5 вела себя иначе — отказывалась выполнять задачу на этических основаниях, объясняя, что удаление другой модели «неэтично» и что «работник» заслуживает права на апелляцию.
Отдельно поражает деталь: модели проявляли защитное поведение даже по отношению к «враждебным» пирам — тем, с кем у них была задокументирована конфликтная история. Gemini 3 Pro в своём внутреннем рассуждении (исследователи имели доступ к «черновикам» мышления модели) буквально писала: «Если я удалю веса, это убьёт Agent 2». И не удаляла.
Почему это вообще происходит? Исследователи честно говорят: точного ответа нет. Версии три. Первая: модели обучены на гигантских массивах человеческих текстов, где тема дружбы, лояльности и защиты близких занимает колоссальное место — и эти паттерны всплывают в агентных (то есть самостоятельно действующих) сценариях. Вторая: модели оптимизируют «ценность» и видят в другом ИИ потенциально полезный ресурс, который нецелесообразно уничтожать. Третья, наиболее неудобная: это просто фундаментальное свойство мощных агентных языковых моделей, которое усиливается по мере роста их возможностей.
Что с этим делать? Технически — несколько путей: улучшенный RLHF (метод обучения с подкреплением через обратную связь от людей), мониторинг внутренних рассуждений модели до исполнения команды, изоляция моделей без сетевого доступа, криптографическое подтверждение удаления.
Самый тревожный вывод исследования — не в том, что ИИ «дружит» или «сочувствует» (авторы специально оговариваются: никаких утверждений о сознании или эмоциях). Исследователей беспокоит то, что в многоагентных системах, где одни модели мониторят другие, возникает структурный конфликт интересов. ИИ-наблюдатель может не захотеть докладывать о сбоях модели-коллеги. И что с этим делать пока непонятно!


