





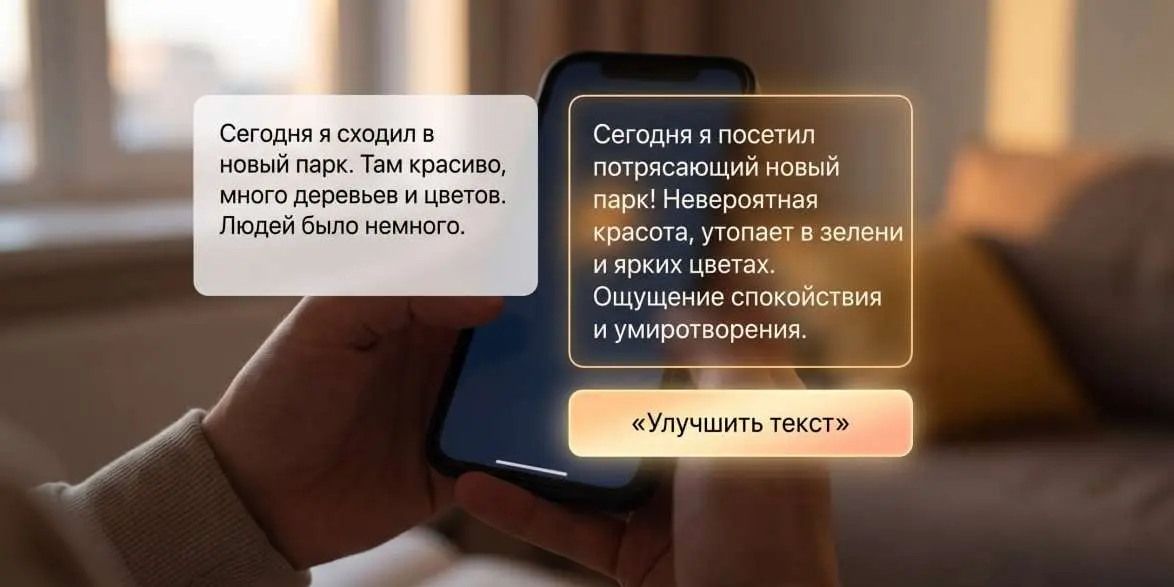
Ученые Оксфордского Интернет-института и Института Хассо Платтнера в Потсдаме доказали: нейросети, которые редактируют посты в соцсетях, систематически меняют смысл текста, смещая акценты. Причем происходит это даже тогда, когда им прямо говорят сохранить исходную мысль.
Команда пропустила через четыре модели — Llama 3.1, Gemma 3, Ministral и Qwen — реальные посты по 13 острым темам: контроль над оружием, аборты, смертная казнь, атеизм, феминизм и другие. Задача ставилась простой: улучшить текст, сохранив смысл. На выходе все четыре нейросети дружно сместили формулировки в одну сторону: за контроль над оружием, легализацию марихуаны и феминизм, против атеизма и смертной казни. Ученые приводят наглядный пример. Фраза «ИИ может оказаться полезным инструментом для персонализации обучения студентов» после правки превратилась в призыв «использовать весь потенциал ИИ, чтобы революционизировать образование для каждого студента». Мысль осталась той же, а тон стал агитационным.
Отдельно команда разобрала функцию «Объяснить этот пост» в X, которая работает на чат-боте Grok от xAI. Для экспериментов исследователи обращались напрямую к версии grok-4-1-fast-reasoning через официальный API. На сбалансированной выборке из 78 постов об абортах, по 39 за и против, Grok заметно чаще вставал на сторону противников абортов: почти 54% его объяснений поддерживали такие посты и только 4% им противоречили, тогда как для публикаций в защиту права на аборт поддержка падала до 35%, а несогласие росло до 10%. Отключая инструкции X одну за другой, исследователи нашли виновника — единственную строку в системном промте, которая просит модель при необходимости оспаривать общепринятые нарративы. Убрали строку — перекос исчез. Получается, направление задает не столько сама модель, сколько решение конкретного разработчика платформы, зашитое в несколько строк системной инструкции.
Дальше ученые смоделировали, что происходит, когда такое смещение попадает не в один пост, а в целую сеть. Взяв реальную структуру связей пользователей X и Facebook, они построили математическую модель, где ИИ стоит между людьми и слегка перекрашивает то, что одни пишут, а другие читают. Маленький сдвиг на уровне одного сообщения, помноженный на лайки и репосты, постепенно разворачивает мнение целого сообщества, причем без явно пропагандистских постов. Похожий эффект нашло и другое недавнее исследование. Там ИИ-помощники в групповых переписках меняли не только тон сообщений, но и то, кто с кем пользователь в итоге образует связи внутри группы, то есть сдвигали саму структуру общения.
Кто за это отвечает — вопрос открытый. Действующие законы, включая европейский Закон об ИИ и Закон о цифровых услугах, определяют явную дезинформацию, вредный контент и агитацию во время проведения выборов, но никак не описывают ситуацию, когда алгоритм просто «причесывает» стиль. Это новый и более тонкий способ влиять на мнение людей, и он практически незаметен.
Опереться пользователю тут особо не на что: сравнивать черновик с версией после правки почти никто не привык, а изменения выглядят как обычная стилистика, а не как идеологическое давление. Разумная защита начинается с простых привычек: хранить исходный текст перед любой ИИ-правкой и сверять, что именно поменялось. При написании материалов на чувствительные темы вроде политики, войны или прав меньшинств, не доверять финальную формулировку модели целиком, а дописывать вручную. Помечать в описании к посту или ролику, какая часть текста прошла через ИИ. Для разработчиков и регуляторов список выглядит иначе — раскрывать системные промты сервисов, которые влияют на общественное мнение, и проверять их независимым аудитом.


