



Amazon закупает партии редких и вышедших из печати книг, срезает у них корешки, чтобы быстрее прогнать страницы через сканер, а затем уничтожает оригиналы. Все это ради данных для обучения собственных ИИ-моделей. Схему раскрыло издание 404 Media: журналисты вложили Apple AirTag в один из тысячи томов, купленных через маркетплейс Biblio, и проследили путь книги через Калифорнию, Висконсин и Колорадо до склада Amazon LAS8 в Лас-Вегасе.
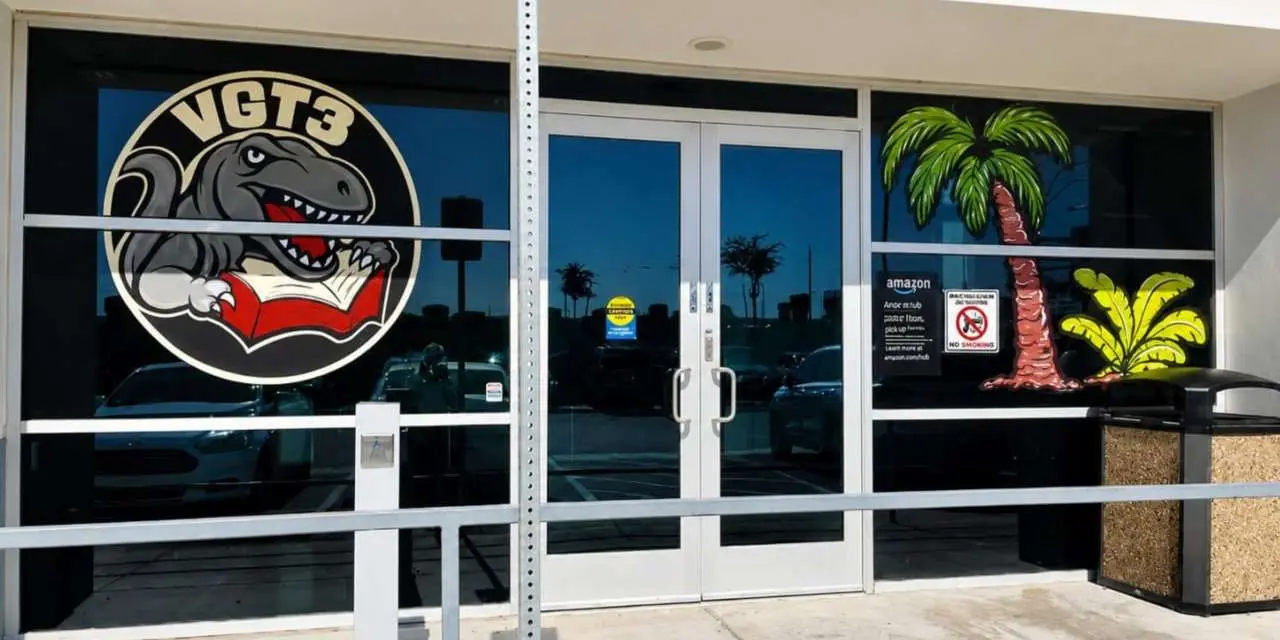
В северной части комплекса работает подразделение под кодовым названием VGT3. Вход туда отмечен логотипом: тираннозавр с книгой в зубах. По словам сотрудников, процесс устроен просто: книги принимают партиями, срезают переплёт, считывают ISBN (уникальный номер каждого печатного издания) и пропускают страницы через сканер. Ранее букинисты обращали внимание на необычные оптовые закупки: заказы были крупными, цена покупателя почти не интересовала, а названия книг казались случайными. Лишь теперь эти покупки удалось связать с конкретной компанией. То, что в VGT3 проверяют именно ISBN, подтверждает версию продавцов: возможно, кто-то последовательно перебирает мировой каталог книг, стремясь оцифровать всё, что когда-либо было издано.
Официально Amazon комментирует скупо: компания закупает книги через коммерческие каналы, чтобы разрабатывать и улучшать продукты и сервисы для клиентов. Про масштаб операции, число уничтоженных книг и конечную модель, которая получает эти данные, представитель говорить отказался. Но бывшие сотрудники говорят, что это нейросеть Nova из семейства ИИ-моделей Amazon.
Все, что издано до 2022 года, гарантированно написано человеком, а значит, свободно от эффекта «коллапса модели» — деградации, которая наступает, когда нейросеть обучается на тексте, сгенерированном другой нейросетью. Многие такие тома при этом нигде не оцифрованы: старые, локальные и малотиражные издания хранят текст, которого больше нет в открытом вебе.
Купить электронную версию было бы проще, но есть нюансы. Лицензия на Kindle-книгу дает право читать, а не право использовать текст как обучающий датасет. Это отдельный вид прав, на котором настаивает и Гильдия авторов США (Authors Guild), и он требует отдельного согласования с правообладателем. К тому же e-book защищен DRM (технологиями защиты цифровых копий от копирования), и извлечь из него чистый текст для внутреннего корпуса — совсем не то же самое, что купить бумажный экземпляр на обычном рынке. А для многих старых и малотиражных изданий легальной электронной версии попросту не существует. Разрезать бумагу и прогнать ее через сканер оказывается технически проще и не требует переговоров с каждым правообладателем о цифровых правах.
Юридически эта дорожка уже расчищена, хотя не до конца. Ключевое решение вынесли не по иску против Amazon, а по делу Anthropic. В июне 2025 года федеральный судья Уильям Алсап в деле Bartz v. Anthropic постановил, что сканирование законно купленных бумажных книг ради внутренней цифровой библиотеки — добросовестное использование (fair use). Отчасти именно потому, что бумажный оригинал уничтожался и не попадал обратно на рынок как копия. Индульгенции на все подряд это решение не дает: многое зависит от происхождения копии и от того, как ее использовали дальше. Но базовую схему оно легализовало, и Amazon, судя по всему, действует в том же правовом поле. Регулятора, который следил бы, сколько книг покупается и уничтожается ради датасетов, при этом попросту нет, а авторы получают ровно ту сумму, за которую в свое время продали физический экземпляр.
Amazon — далеко не первый среди ИИ-варваров, скармливающих библиотеки нейросетям. Судебное разбирательство, открывшее ту самую легальную лазейку, касалось самой Anthropic. Рассекреченные документы, изученные The Washington Post, раскрыли внутреннее название программы — Project Panama («Проект Панама»). Её цель формулировалась довольно цинично: оцифровать все книги мира, правда, при этом физический носитель уничтожался. Компания закупала миллионы печатных экземпляров, срезала с них переплёты, сканировала страницы и добавляла полученные тексты в собственную цифровую библиотеку. Именно она стала одной из основ для обучения моделей Claude.
Весной 2026 года похожую ситуацию заметили и в Германии. С начала мая, по данным швейцарской вещательной корпорации SRF, у немецких онлайн-антикваров стали появляться систематические ночные заказы: примерно с трех до пяти утра, автоматизированные и крупные. Покупали не раритеты, а залежавшийся нон-фикшн после 1970 года, кулинарные книги, биографии и художественную литературу, причем строго по одному экземпляру каждого названия, что не похоже ни на перепродажу, ни на комплектование обычной библиотеки. Отраслевое издание Börsenblatt зафиксировало похожие заказы у продавцов по всему немецкоязычному региону вместе с подозрением, что после сканирования книги уничтожают. Покупателем называли канадскую Zoom Books, которая отрицает всякую связь с обучением ИИ и настаивает на обычной торговле и переработке книг. Прямой связи с Amazon или Anthropic источники не подтверждают, но узнаваемый почерк говорит сам за себя.
На этом фоне Google выглядит скорее исключением, чем частью общей картины. Библиотечный проект Google Books с 2004 года оцифровал больше 40 миллионов книг на пяти сотнях языков и не уничтожил при этом ни одного оригинала. Технология сканирования там неразрушающая: том аккуратно фотографируют и возвращают владельцу, обычно через один-два месяца. Летом 2026 года к проекту присоединилась библиотека Ohio University: книги отправляют в американский центр оцифровки, сканируют и везут обратно на полку, при этом сама библиотека все время сохраняет право собственности на физический экземпляр и в придачу получает цифровую копию для читателей.


